Los gráficos de dispersión muestran la relación entre dos variables numéricas. En pandas se crean con plot.scatter, indicando las columnas para los ejes X e Y.
Gráfico de dispersión con plot.scatter
Pasa los nombres de las columnas a x e y.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

rng = np.random.default_rng(8)
height = rng.normal(170, 9, 300)
df = pd.DataFrame({"altura": height,
                   "peso": 0.9 * height - 85 + rng.normal(0, 7, 300),
                   "edad": rng.uniform(18, 70, 300).round(),
                   "sexo": rng.choice(["Mujer", "Hombre"], 300)})

df.plot.scatter(x = "altura", y = "peso")
# plt.show()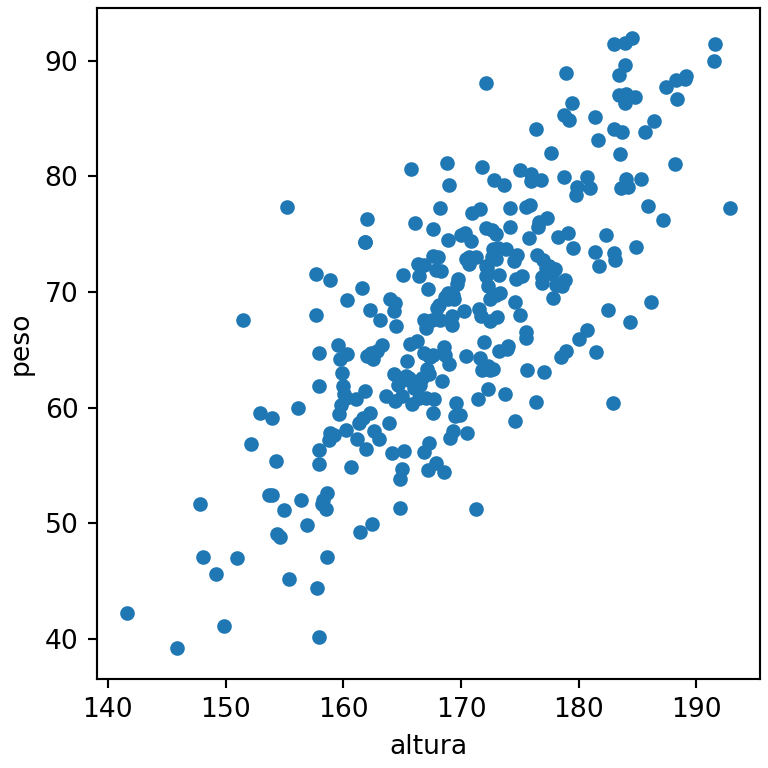
Color según una variable
El argumento c colorea los puntos según los valores de una columna. Con una columna numérica se agrega una barra de color; elige los colores con colormap.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

rng = np.random.default_rng(8)
height = rng.normal(170, 9, 300)
df = pd.DataFrame({"altura": height,
                   "peso": 0.9 * height - 85 + rng.normal(0, 7, 300),
                   "edad": rng.uniform(18, 70, 300).round(),
                   "sexo": rng.choice(["Mujer", "Hombre"], 300)})

df.plot.scatter(x = "altura", y = "peso", c = "edad", colormap = "viridis")
# plt.show()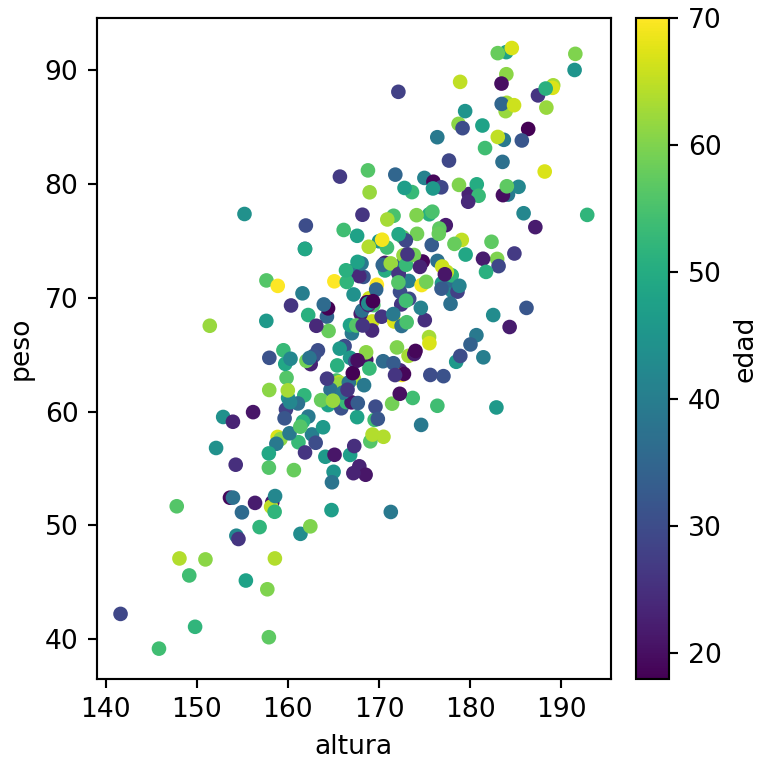
Color por grupo
Para colorear los puntos según una variable categórica asigna un color a cada grupo.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

rng = np.random.default_rng(8)
height = rng.normal(170, 9, 300)
df = pd.DataFrame({"altura": height,
                   "peso": 0.9 * height - 85 + rng.normal(0, 7, 300),
                   "edad": rng.uniform(18, 70, 300).round(),
                   "sexo": rng.choice(["Mujer", "Hombre"], 300)})

colors = {"Mujer": "#E76F51", "Hombre": "#264653"}

df.plot.scatter(x = "altura", y = "peso", c = df["sexo"].map(colors))
# plt.show()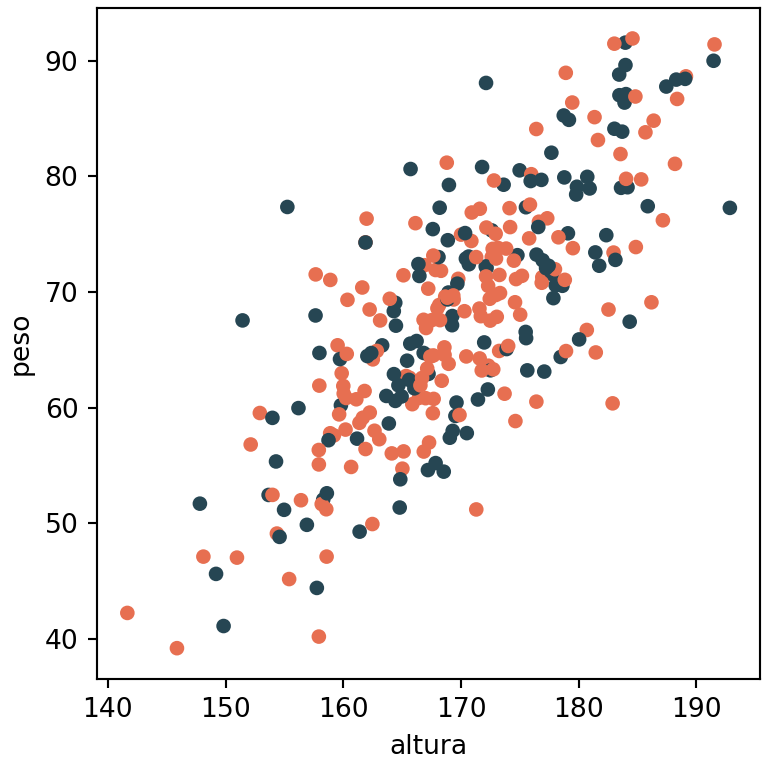
Tamaño de los puntos
s establece el tamaño de los puntos. Pasa un número para un tamaño fijo o una columna para crear un gráfico de burbujas.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

rng = np.random.default_rng(8)
height = rng.normal(170, 9, 300)
df = pd.DataFrame({"altura": height,
                   "peso": 0.9 * height - 85 + rng.normal(0, 7, 300),
                   "edad": rng.uniform(18, 70, 300).round(),
                   "sexo": rng.choice(["Mujer", "Hombre"], 300)})

df.plot.scatter(x = "altura", y = "peso", s = df["edad"] * 2, alpha = 0.5)
# plt.show()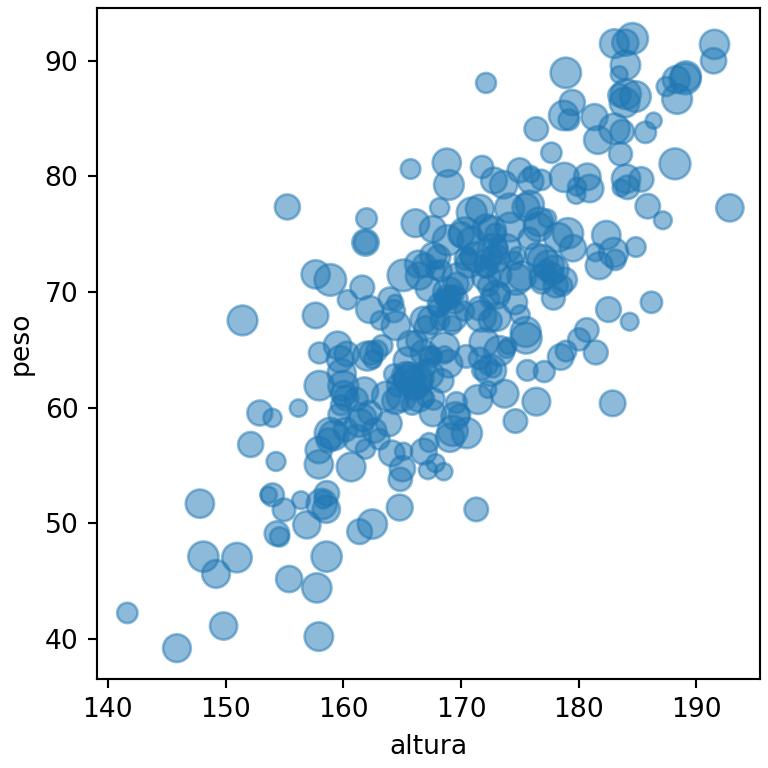
Matriz de dispersión
pandas.plotting.scatter_matrix crea un gráfico de dispersión para cada par de columnas numéricas y un histograma en la diagonal.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

rng = np.random.default_rng(8)
height = rng.normal(170, 9, 300)
df = pd.DataFrame({"altura": height,
                   "peso": 0.9 * height - 85 + rng.normal(0, 7, 300),
                   "edad": rng.uniform(18, 70, 300).round(),
                   "sexo": rng.choice(["Mujer", "Hombre"], 300)})
from pandas.plotting import scatter_matrix

scatter_matrix(df[["altura", "peso", "edad"]], figsize = (5, 5), alpha = 0.5)
# plt.show()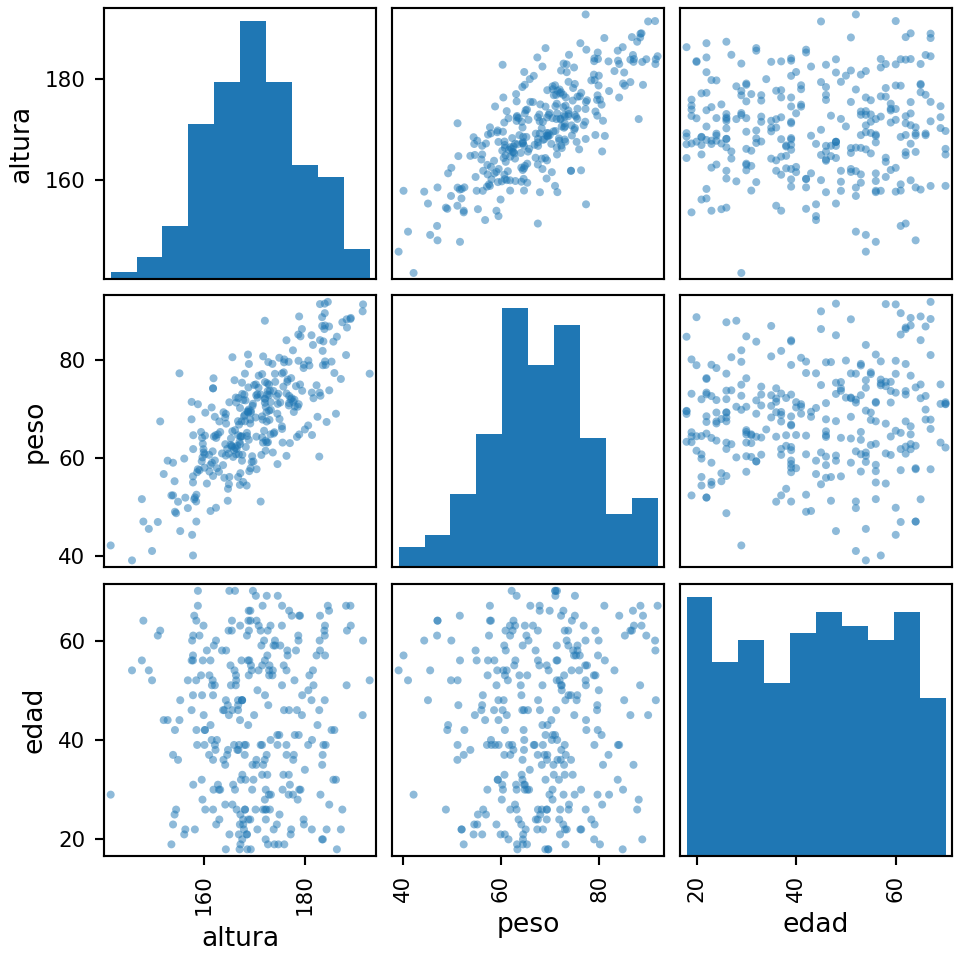
Gráfico hexbin para muchos puntos
Cuando hay muchos puntos se solapan. plot.hexbin los agrupa en hexágonos coloreados según el número de observaciones.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

rng = np.random.default_rng(8)
height = rng.normal(170, 9, 300)
df = pd.DataFrame({"altura": height,
                   "peso": 0.9 * height - 85 + rng.normal(0, 7, 300),
                   "edad": rng.uniform(18, 70, 300).round(),
                   "sexo": rng.choice(["Mujer", "Hombre"], 300)})

df.plot.hexbin(x = "altura", y = "peso", gridsize = 15, cmap = "Blues")
# plt.show()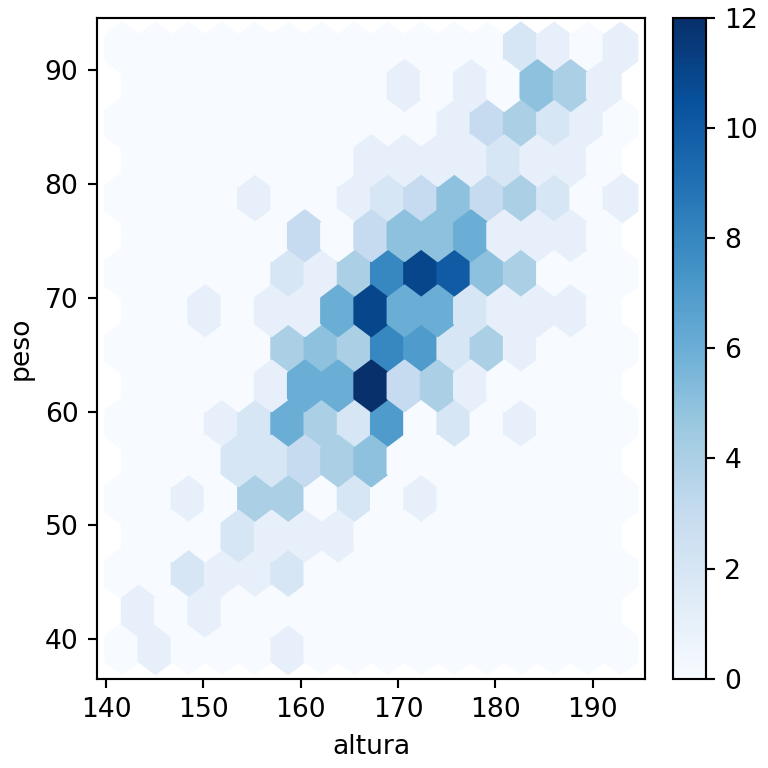
Consulta también cómo crear un gráfico de dispersión en matplotlib o en seaborn y la guía sobre gráficos con pandas.